Données propriétaires
Observatoire des fautes d'orthographe
Quelles erreurs sont détectées dans les dictées, et à quel niveau de texte ? La méthode de mesure est décrite ci-dessous ; les résultats seront publiés niveau par niveau dès que le seuil de publication sera atteint.
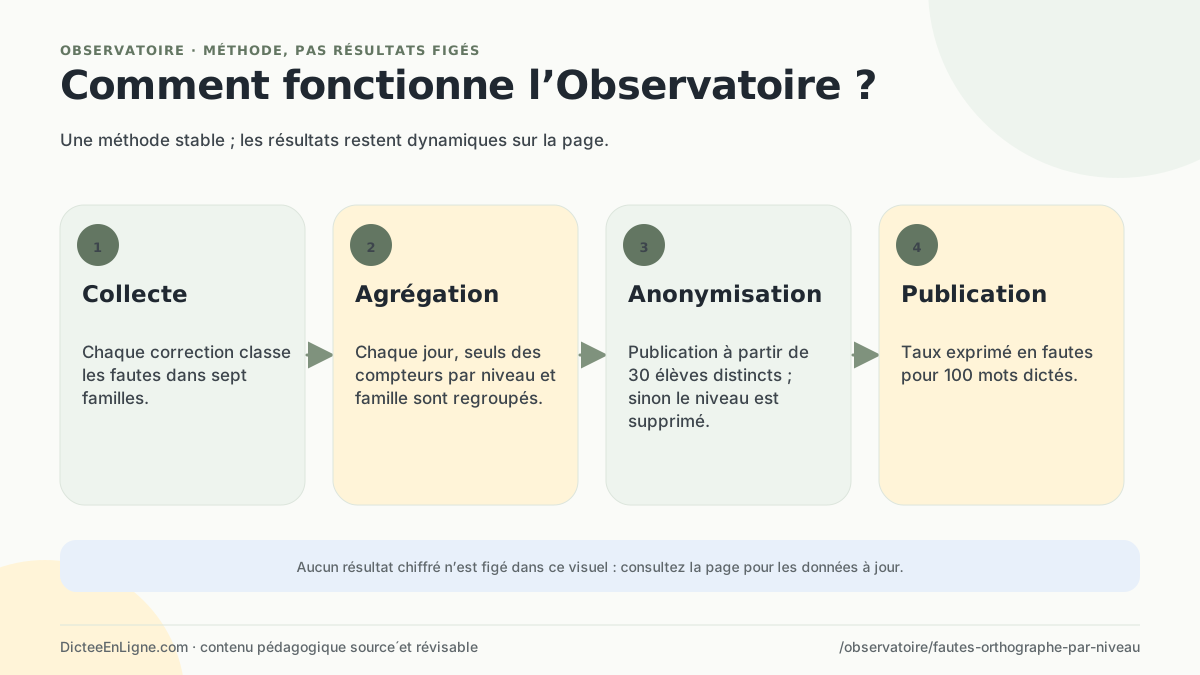
L'observatoire mesure la fréquence des erreurs d’orthographe détectées automatiquement par niveau scolaire, à partir des dictées corrigées automatiquement sur le site. Chaque erreur détectée est classée dans l'une des sept familles d'erreur et les résultats sont exprimés en fautes pour 100 mots dictés, une fois le seuil de publication atteint.
Faites défiler le visuel horizontalement pour lire la suite.
Pourquoi mesurer les familles de fautes plutôt que leur nombre
Les familles d’erreur décrivent les catégories attribuées par la correction automatique dans les dictées observées. Les taux pour 100 mots facilitent la lecture de ce corpus, mais dépendent des textes, des participants et du classement automatique.
Ces résultats ne permettent ni de diagnostiquer les difficultés d’un élève, ni de déduire l’effet du programme scolaire, ni de promettre une durée de remédiation. Pour choisir une révision, examinez aussi les productions de l’élève et les conseils de son enseignant.
Ce que ces chiffres ne disent pas
Trois limites méritent d'être posées clairement, parce qu'un chiffre sans ses limites se fait citer de travers.
L'échantillon n'est pas représentatif. Il décrit les participations des profils qui utilisent ce site — un échantillon auto-sélectionné dont la représentativité n’est pas établie. Ces données servent à comparer les familles d'erreurs entre elles, pas à estimer un niveau national.
La détection dépend de l'outil. Les fautes sont repérées et classées automatiquement. Le classement d'une faute ambiguë entre deux familles voisines — un accord manqué peut relever de l'accord ou de la conjugaison — comporte une part de convention.
Un taux n'est pas un jugement. Une famille très représentée décrit ce corpus seulement. Le choix des textes et le niveau des participants peuvent influencer les taux ; aucune causalité scolaire n’est établie.
Les résultats ne sont pas encore publiés
La mesure est en cours. Un niveau n’est publié qu’à partir de 30 profils apprenants distincts sur une même journée de Paris. En dessous de ce seuil, les résultats restent masqués.
La méthode et les limites des anciens agrégats sont décrites ci-dessous. Une modification du calcul ne permet pas de réinterpréter automatiquement les anciens résultats.
La méthode de mesure
Publiée intégralement, parce qu'un chiffre dont on ignore le mode de calcul ne vaut pas grand-chose.
Les tentatives proviennent des dictées libres, du jeu quotidien et du programme. Leur correction automatique fournit une liste de fautes classées dans sept familles. Le détail d’une tentative invitée récupérée peut venir du client : son format est contrôlé, sans nouvelle correction automatique pour vérifier le contenu.
Les nouveaux calculs quotidiens retiennent les listes de fautes exploitables, avec uniquement des catégories reconnues, y compris une liste explicitement vide. Une liste absente, mal formée, partiellement filtrée ou plafonnée est exclue des fautes, tentatives, mots et profils comptés. Les compteurs sont regroupés par niveau de dictée et par famille ; la validité du format ne certifie pas la justesse pédagogique.
Un niveau est publié à partir de 30 profils apprenants distincts sur une même journée. Le maximum journalier sert à ce seuil ; les niveaux en dessous restent masqués. Une même personne utilisant plusieurs profils peut être comptée plusieurs fois : il ne s’agit pas d’un recensement de personnes.
Les taux sont exprimés en erreurs pour 100 mots des tentatives incluses. Une catégorie à zéro indique qu’aucune erreur de cette famille n’a été comptée dans ces tentatives ; ce n’est pas la preuve d’une compétence acquise. Les tentatives et les mots sont cumulés, tandis que le nombre de profils reste un maximum journalier.
Réutiliser ces données
Ces statistiques sont librement réutilisables sous licenceCC BY 4.0, à condition de citer « Dictée en ligne » avec un lien vers cette page. Les niveaux n’ayant jamais atteint 30 profils apprenants distincts sur une même journée sont exclus des exports. Les champs learnerCount (JSON) et learner_count (CSV) conservent leur nom pour compatibilité : ils désignent ce maximum journalier, pas un total de personnes sur la période.
Intégrer le graphique
Questions fréquentes
D'où viennent ces données ?
Comment la confidentialité est-elle protégée ?
Que signifie « fautes pour 100 mots » ?
Ces chiffres sont-ils représentatifs des élèves français ?
À quelle fréquence les données sont-elles mises à jour ?
Publié sous la responsabilité d’Alexandre Orfèvre. Mis à jour le 3 octobre 2026. Notre méthode pédagogique détaille comment chaque contenu est préparé, et ses limites.
Connaître la répartition des fautes de votre enfant
Une dictée corrigée propose un classement des erreurs détectées. Relisez les explications pour choisir une notion à réviser.